通往billion context之路
前段时间pi社区有一个billion context插件,这个插件的原理大概是让agent自己总结文本块,后续按需搜索块内被总结的文本,这是一个很有意思的设计,但是这个设计也存在一些设计哲学上的问题,此处先按下不表。笔者这篇文章想要探讨的是billion context,或者aka无限上下文,在目前现实的工程约束下到底该如何达成?
#pi压缩机制的问题
抛开功能少不谈,pi确实是目前最好的harness,但功能少本身就是刻意而为之的,所以不是缺点。pi在默认状态下并不太可能成为一个在长程任务上表现优秀的harness,pi的压缩有两方面的问题:一是负责压缩上下文的agent收到的context是pi重新组装后的,具体组装逻辑不说了,但重新组装后的上下文破坏了前缀稳定性(虽然这可以显著减少发送给压缩agent的上下文)从而导致cache miss,这导致花费增加;二是pi的压缩prompt天生会导致信息损耗,部分情况下严重影响长程任务表现
关于总结过程中的前缀命中问题,我依稀记得社区里有人提过相应的pr然后被搁置了,但这还是很必要的。解决方法就是前缀原样发送,在最后附上压缩的prompt
最重要的肯定还是信息损耗的问题。pi的压缩prompt要求默认的摘要分为六部分,Goal, Constraints & Preferences, Progress, Key Decisions, Next Steps和Critical Context,并且压缩prompt要求agent保持语言简洁,文件路径、函数名和报错信息要原样保留。这导致了三个问题:
第一个问题是,agent在压缩时为了达到简洁的要求可能会不得不抛弃一些必须被保留但是又很长的重要信息。比如,假设现在clickhouse不存在,你脑子里有了一个绝佳的clickhouse架构设计的想法并且和agent讨论拍板了,但是你们讨论得出的架构设计应当是相对详细的,不可能简短的一两句就概括掉,你们可能还会讨论得出一些实现的step等,但这些信息大概率在压缩后的上下文里不存在,只因为太长了就被模型按要求省略了。
第二个问题是,整个压缩后context的结构要求就是有问题的。例如有一个section叫Key decision,单独来说这个section是没有存在的意义的,或者说意义本身就不明,critical context也一样。什么算作是关键决定?什么算重要上下文?模型按照什么标准决定?相对之下,其他几个section的内容都相对比较好决定,但是我提到的这两个section缺少标准。
其次,究竟什么应该在压缩后的上下文中?当然是任务。每个session都是为了达到某种目的,或者说完成某个任务,压缩后的上下文应该围绕这一点。所以目标一定是必须的,在这个框架下,第一个问题导致压缩后“如何达成目标”的信息会被省略,第二个问题提到的“关键决策”本质应该就是对“如何达成目标”的表述,但是在实践中依据现有pi的prompt得到的总结内容往往会夹杂太多东西,这就是为什么笔者说“关键决策”缺少判定标准。在笔者的框架下,关键决策、或者说“如何达成目标”的信息,应该跟着目标走,而单独的key decision这一section应该被彻底去掉
第三个问题更像是一个模型能力的问题,现有的pi压缩prompt缺少足够的引导来告诉agent如何判断什么是用户的目标,或者说这个prompt在语义上具备一定的误导性,相关部分如下:
#Goal
[What is the user trying to accomplish? Can be multiple items if the session covers different tasks.]
is可能会让总结上下文的agent会倾向于把用户手头即将完成的工作当成goal,而在长程任务中,用户即将完成的工作应当是一个更大目标的一小步。在我使用Opus5.5的这么长时间里,我发现这样的问题很普遍,这会导致原本的Bigger picture在压缩的过程中可能被丢失。
在笔者的框架中,压缩后的上下文应该包含必要的、详细的有关目标以及如何实现的信息,这一部分信息在保持详尽的同时其实只会占据比较少的上下文,这会让总结后的上下文显著变多,但对于长程任务可以忽略不计,并且也是极为必要的取舍。除此以外就是用户的一些偏好,一些项目的相关信息,以及完成任务的进度表,除此之外没有必要的东西了。笔者认为,哪怕是billion context,你所需要的上下文摘要也只不过是这些,因此,下面笔者会谈一下对billion context这个插件的看法
#Persisted State is all you need
billion context其实说白了是分块总结+搜索的思路,上下文依据message(或者说turn)进行分块,每个turn是块中的最小单位,模型选择turn范围进行压缩总结为块,总结后的上下文到最后变成了若干个块的拼装,而不同的块之前还可以再进行总结压缩,再进一步生成更高级别的块。我让DeepSeek给我画了个图,大概长这样
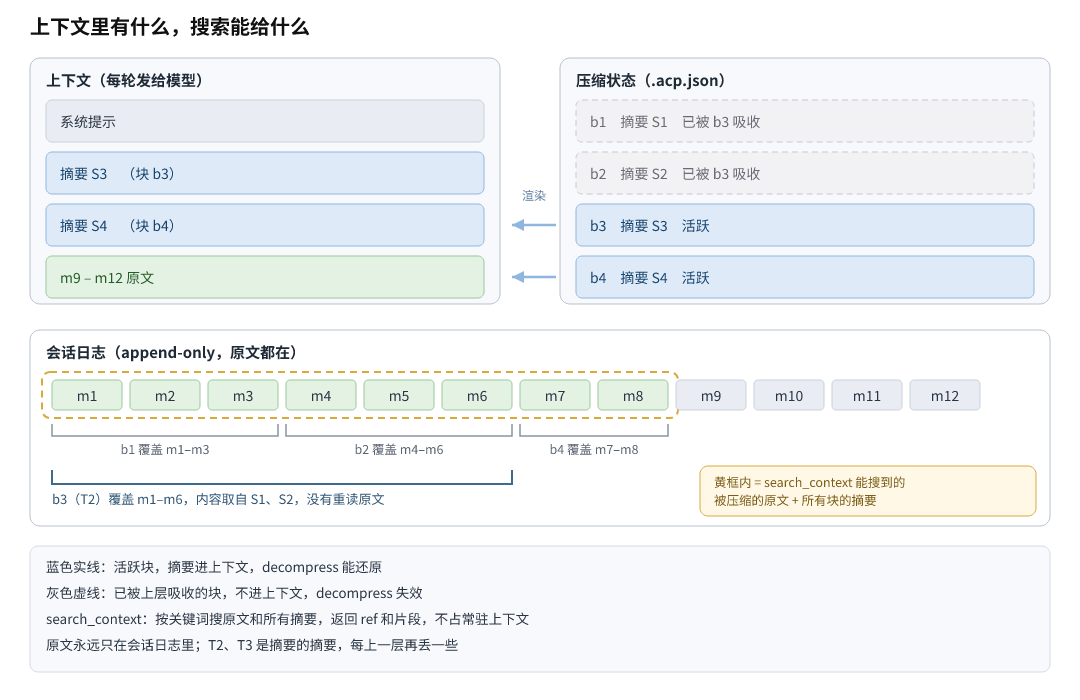
这个设计从哲学上讲有个重大问题,或者也可以理解为它面向的似乎是另一种人群。在当整个session是为了完成一个或者几个相近的目标的时候,没有任何必要进行分块。如果分块,那么第一块是我们干了A,第二块是我们干了B,到最后agent看到的是一长串的流水账,而事实上:
每个块之间本身就是有关联的,他们服务的是一个共同的目标,这样的上下文压缩组织弱化了逻辑性,并且呈现起来就像是流水账,每个块的总结可能会呈现出一些对当前工作没有意义的无关信息(甚至可以理解为这就是为什么要二次、三次压缩已经经过压缩的块内容)
块之间有先后顺序,这先后顺序大概都是完成子任务/小目标的先后顺序,但是原始的、根据对话历史决定的先后顺序不一定是最符合强逻辑的先后顺序
模型如何决定哪些块应该merge,如果整个session都是服务于一个终极目标,分块有何意义?当哪些turn应该被分进一个块的选择权交给模型后,模型因为能力不足给出了并非最优的分块决定是否意味着上下文压缩的效果减弱了?
相比之下,pi从始至终都只有一个persisted state,就是笔者此前提到的pi原始行为定义六部分,这显然是一个更合乎逻辑的压缩模型。所有的压缩都是为了更新这个state,这个state(每次压缩后的信息)在整个session中自第一次压缩开始始终存在,在这个意义上这个状态是被持续化的,并且被后续压缩不断更新。
除此之外,billion context还给了一个搜索的工具,坦诚来讲,笔者认为harness中所有类似的搜索上下文的工具都不应该存在。一是因为如果不根据语义匹配,那么基于关键字的匹配有可能会miss;二是基于关键字的匹配同样可能匹配到大量的不相关内容从而污染上下文。
billion context的模型,看上去更适合的场景似乎是当整个对话为若干的不太相关的目标服务的时候,而笔者提出的模型从某种程度上讲可以被视作billion context的一个块。billion context从某种意义上literally是为了达到billion context从而分了很多块,但是笔者私以为LLM的运作方式和现有的infra决定了一个session其实本身只适合完成一个大目标,笔者自动压缩设置的是400k上下文,超了400k后账单太贵。真正的面向多个弱相关目标的billion context可能本身并没有意义,因为多个弱相关目标本身不应该在单个session完成
综上,笔者认为所谓的billion context本质应该专注于如何可靠做好一件事上,而当你只有一个最终目标的同时,billion context并无太大意义,除非相应session真的在完成极其复杂的任务,任务复杂到persisted state都来到了200k甚至更高水平的时候,只有在这种时候分级存储才有意义。而分级存储的逻辑不需要多复杂,笔者也是见识过(阅读过)不少开源项目,在笔者看来,特别复杂并且已经完成的设计点完全可以在persisted state中简单陈述一下,并且注明详细实现放在了某某markdown文档里,笔者私以为这样的效果应该比billion context更好
#我们的明天
以上仅为个人观点,真实的harness engineering应该尊重事实与经验,并且在试错中不断完善。笔者个人认为,一切问题都是harness的问题,而不断完善个人的私有harness已然成为了这个时代的程序员最应该做的事情。未来开发私有harness必然会越来越普遍,门槛也越来越低。在AI时代能茁壮成长的程序员必定是擅长架构设计和对harness有独特理解的程序员,只会机械指挥agent干活的average codex user很可能只会在两年后迎来被淘汰的命运
希望AI能让各位少掉一些头发,多享受一些生活